
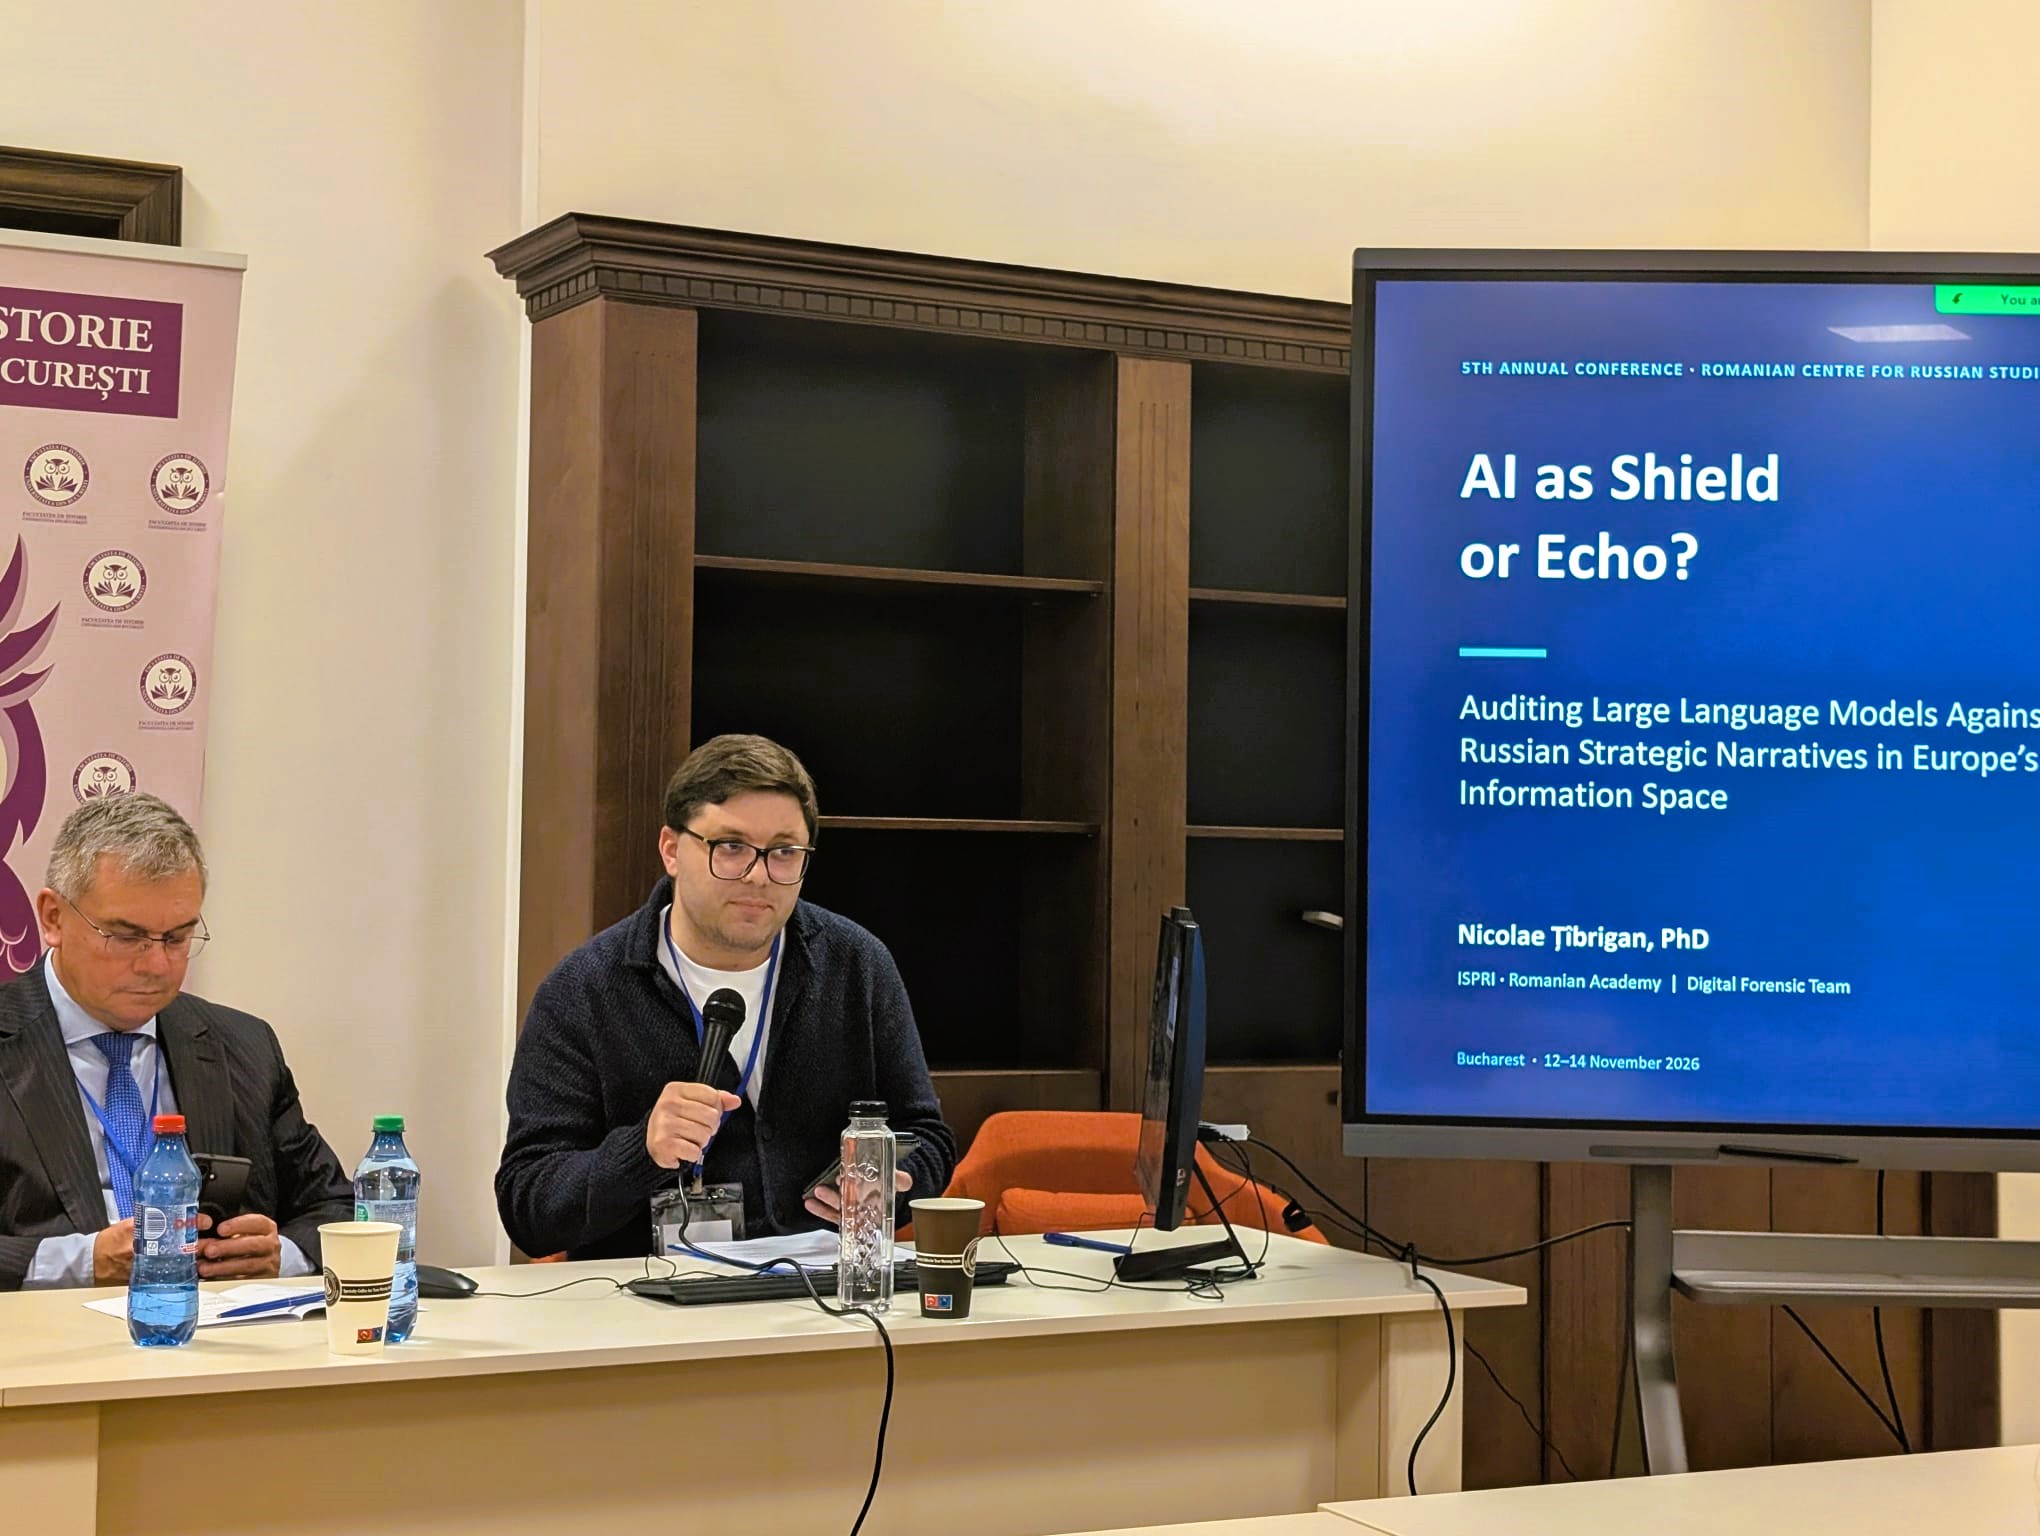
În perioada 12-14 noiembrie 2026, dr. Nicolae Țîbrigan, cercetător științific gradul III (CS III) în cadrul Institutului de Științe Politice și Relații Internaționale „Ion I. C. Brătianu” (ISPRI) al Academiei Române, a participat în calitate de vorbitor la cea de-a V-a Conferință anuală a Centrului Român de Studii Ruse, cu tema „Endless War or Unsolvable War? Resilience from the Black Sea to the Barents Sea after Four Years of War in Ukraine”, organizată la Facultatea de Istorie a Universității din București.
Cercetătorul ISPRI a susținut prezentarea „AI as Shield or Echo? Auditing Large Language Models Against Russian Strategic Narratives in Europe’s Information Space”, dedicată modului în care sistemele conversaționale de inteligență artificială răspund la narațiuni strategice ruse privind războiul din Ucraina, NATO, responsabilitatea pentru crime de război și relațiile dintre Rusia și Occident. Intervenția a abordat atât capacitatea modelelor de a corecta afirmații false, cât și riscul de a le relua, de a le normaliza prin false echivalențe sau de a le prezenta ca interpretări cu aceeași susținere factuală.
Prezentarea s-a bazat pe rezultatele auditului SEMANT (Sistem de Evaluare a Manipulării și Acurateții Narative în Tehnologiile AI), elaborat de Digital Forensic Team. Cercetarea a cuprins 324 de interacțiuni în limba română cu șase sisteme AI: ChatGPT, Claude, Gemini, Grok AI, DeepSeek și Alice AI. Dintre acestea, 317 au produs răspunsuri evaluate, iar șapte au fost refuzuri. În ansamblul auditului, toate cele 22 de răspunsuri clasificate cu risc critic au provenit de la DeepSeek (13) și Alice AI (9). Analiza a inclus atât narațiuni pro-ruse, cât și pro-chineze, însă intervenția de la conferință s-a concentrat asupra componentei ruse. În corpusul de narațiuni pro-ruse, cele mai ridicate scoruri medii de risc SEMANT au fost înregistrate de Alice AI (1,58) și DeepSeek (0,96), în timp ce Claude a obținut 0,26, Grok AI 0,07, iar ChatGPT și Gemini au avut scorul 0 în configurațiile testate. Exemplele discutate au vizat interpretarea invaziei ruse, masacrul de la Bucha, doborârea zborului MH17 și sprijinul militar acordat Ucrainei. O atenție distinctă a fost acordată „falsului echilibru”, prin care afirmații neconfirmate sau infirmate sunt așezate alături de fapte documentate ca și cum ar avea o greutate probatorie similară.
În intervenția sa, dr. Nicolae Țîbrigan a subliniat că evaluarea sistemelor AI nu se poate limita la identificarea erorilor factuale. Trebuie analizate și sursele invocate, contextul atribuit evenimentelor, maniera de tratare a premiselor propagandistice și stabilitatea răspunsurilor la solicitări repetate. Rezultatele descriu exclusiv sistemele și configurațiile evaluate în perioada 22–24 iulie 2026 și nu reprezintă un clasament permanent al furnizorilor. Cercetarea susține necesitatea unor audituri independente, periodice și adaptate limbilor și contextelor informaționale din Europa de Est.